Poznato je da se većina ljudi nemarno odnosi prema svojim lozinkama. Troj Hant, softverski inženjer i dobitnik "Microsoftove" MVP nagrade, analizirao je nedavni napad hakera na "Sony" i napisao analizu lozinki koje se koriste.
Rezultati su bili alarmantni, lozinke su bile relativno kratke, obično šest do 10 znakova, jednostavne i predvidljive, a više od trećine njih može se pronaći u uobičajenim rječnicima. Ono što još više brine je jedinstvenost. Naime, 92 odsto računa u informacionim sistemima "Sonyja" koriste iste lozinke, pa čak kad se gleda i na druge sisteme.
Na osnovu 300.000 računa, Hant je napravio selekciju i izdvojio neke zaključke.
Oko 14 odsto korisnika kreira svoju lozinku iz ličnog imena. Osim imena, postoje još tri derivacije koje se učestalo pojavljuju u lozinkama. To su dodavanje brojeva, dodavanje simbola i obrtanje imena. Oko osam odsto korisnika kreira svoju lozinku na osnovu imena mjesta, grada, države, regije. Riječi iz rječnika su najpopularniji izvor za inspiraciju za kreiranje lozinke. Najpopularnije lozinke iz rječnika su password, monkey i dragon. Brojeve u lozinkama koristi oko 14 odsto korisnika. Dvostruke riječi, odnosno uzastopne riječi koje se ponavljaju u lozinkama, poput "troytroy" je manje od tri odsto.
Mnogi ljudi, kako ne bi zaboravili svoju lozinku, koriste dio svoje e-mail adrese kako bi ih podsjetila na odabranu lozinku. I ovdje je manje od tri odsto lozinki. Kratke fraze bilo je najteže kvantifikovati, međutim, ljudi ih i te kako koriste u odabiru lozinki. Tri najpopularnije kratke fraze su "trustno1", "letmein" i "iloveyou".
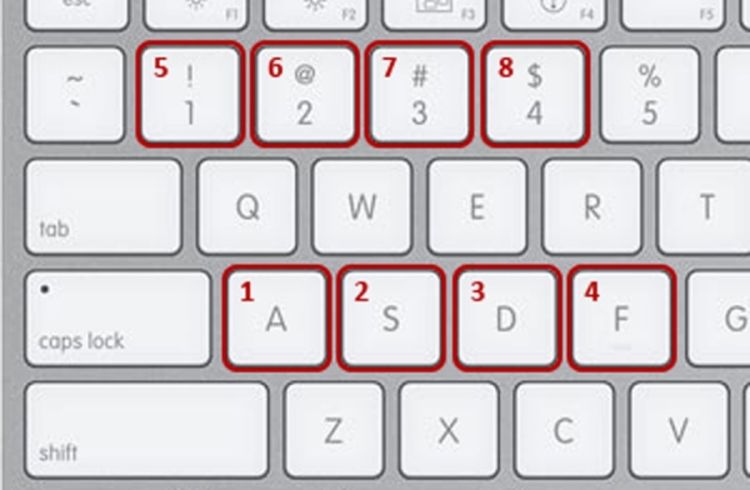
Obrazac tastature neki bezbjednosni "stručnjaci" dugo su smatrali najpouzdanijim načinom za odabir lozinke. Takvu lozinku lako je pamtiti, a najpopularnije lozinke koje su tako generisane su: "qwerty", "asdfgh" i "asdf1234".
Na kraju, Hant je naveo tri zaključka koji proizlaze iz njegovog istraživanja: lozinke su inspirisane riječima koje za nas imaju lični značaj ili nekim drugim obrascem kojeg se možemo sjetiti, pokušaji da lozinke budu pojačane obično slijede predvidljive obrasce i u potpunosti slučajne lozinke su vrlo rijetke, na njih otpada samo jedan odsto istraženih podataka.